Llevamos nuestro asistente de voz a Eleven v4 Turbo: qué cambia y con qué tecnología funciona
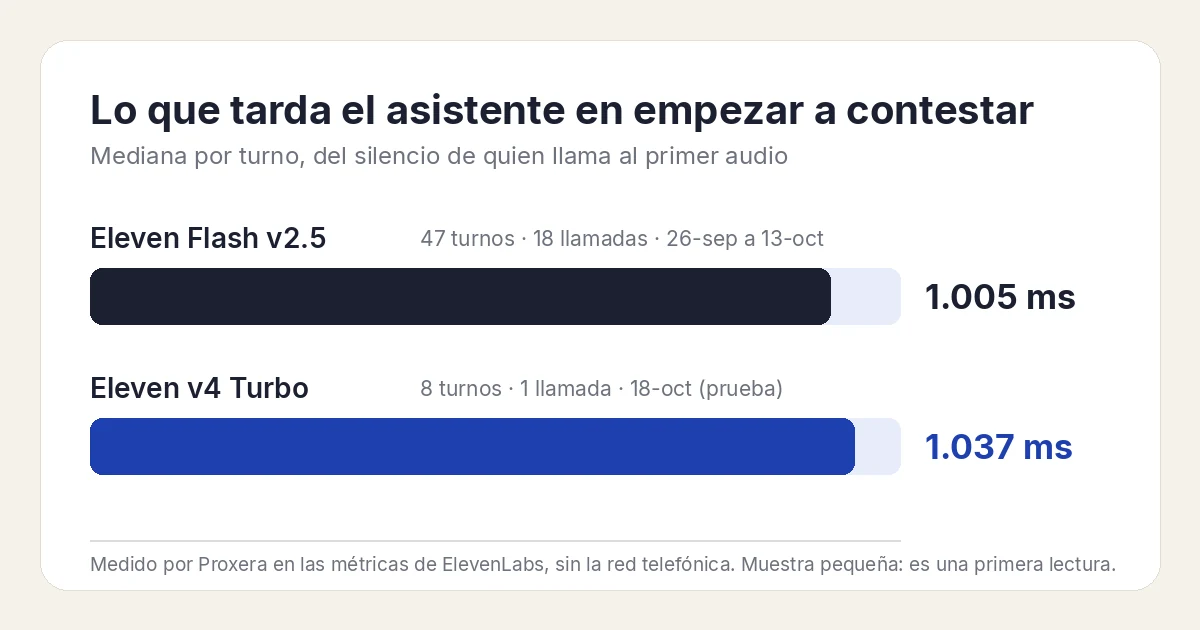
Eleven v4 Turbo es el modelo de texto a voz que ElevenLabs ha sacado para agentes que hablan en tiempo real, y desde el 18 de octubre de 2026 es el que usa nuestro asistente de voz. Según ElevenLabs, es más expresivo que los anteriores y habla más de 90 idiomas. En nuestra prueba, la espera hasta que el asistente empieza a contestar fue casi la misma que con el modelo anterior: 1.037 ms de mediana frente a 1.005 ms, con una muestra todavía pequeña.
Hasta ahora nuestro asistente de voz para negocios hablaba con Eleven Flash v2.5, otro modelo de ElevenLabs pensado para tiempo real. Este artículo cuenta qué trae el nuevo, qué medimos antes de cambiar, qué cambia para quien llama y, de paso, con qué tecnología funciona cada canal de Proxera.
Qué es Eleven v4 Turbo, según ElevenLabs
ElevenLabs presentó la familia v4 el 28 de septiembre de 2026 en su anuncio «Eleven v4: Our most expressive text-to-speech AI model yet», actualizado el 12 de octubre. Son dos modelos con usos distintos:
| Eleven v4 | Eleven v4 Turbo | |
|---|---|---|
| Para qué lo recomienda ElevenLabs | Locuciones, audiolibros, personajes | Agentes conversacionales y voz interactiva en tiempo real |
| Latencia que publica | No da cifra | Mediana de inferencia de ~100 ms |
| Idiomas | Más de 90 | Más de 90 |
Fuente: documentación de modelos de ElevenLabs y página de Eleven v4, leídas el 18-oct-2026.
Para una llamada de negocio, el que cuenta es v4 Turbo. ElevenLabs lo describe como su modelo de síntesis de voz en tiempo real «más expresivo» y lo pone, literalmente, para «agentes de soporte que resuelven las consultas de los clientes en tiempo real».
Lo que dice que mejora, siempre según ElevenLabs:
- La voz no cambia a mitad de conversación. Usa un método nuevo para capturar la identidad de cada voz y dice que la mantiene «con más fiabilidad» entre frases, diálogo y narración.
- Sigue mejor las indicaciones de cómo decir una frase, escritas en lenguaje natural o con etiquetas, «con más precisión que los modelos anteriores». Su propia página reconoce que esas etiquetas «aún no son perfectas».
- Una misma voz puede hablar otro idioma con acento nativo y conservar su timbre.
- Más de 90 idiomas, entre ellos el catalán.
Lo que Eleven v4 Turbo no es: más rápido de modelo
Aquí hay una trampa fácil de pisar. Según la misma documentación de ElevenLabs, el modelo que usábamos tiene una latencia de inferencia de ~75 ms, y v4 Turbo, de ~100 ms. Las dos cifras llevan la misma nota: no incluyen la latencia de la aplicación ni la de la red.
| Modelo | Latencia de modelo que publica ElevenLabs | Idiomas |
|---|---|---|
| Eleven Flash v2.5 (el anterior) | ~75 ms | 32 |
| Eleven v4 Turbo (el de ahora) | ~100 ms | Más de 90 |
En el anuncio, ElevenLabs sí presenta v4 Turbo como el más rápido, pero frente a otros cuatro proveedores (Cartesia, xAI, Google y OpenAI), no frente a sus propios modelos: una mediana de ~150 ms hasta que se oye la voz, medida por ellos en septiembre de 2026, por WebSocket y sin contar la red. Son 100 ms y 150 ms porque miden cosas distintas: una es lo que tarda el modelo, la otra lo que tarda en sonar.
Así que lo que v4 Turbo promete no es velocidad. Es naturalidad e idiomas, sin dejar de ser de tiempo real. Si eso cuesta unas decenas de milisegundos, había que ver si se nota en una llamada. Y eso no lo dice ninguna ficha técnica: hay que medirlo.
Lo que medimos antes de cambiar
No cambiamos el modelo de un asistente que ya atiende llamadas porque haya salido uno nuevo. Primero montamos un agente de prueba, copia del de producción: mismo guion, mismas reglas, el mismo modelo que decide las respuestas y los mismos ajustes de turno y de reconocimiento de voz, con su propio número y sin atender a nadie de fuera.
De cada conversación, ElevenLabs guarda métricas por turno. La que miramos es el tiempo desde que quien llama deja de hablar hasta que sale el primer audio del asistente, dentro de la plataforma y sin contar la red telefónica.
| Eleven Flash v2.5 (producción) | Eleven v4 Turbo (prueba) | |
|---|---|---|
| Mediana de espera por turno | 1.005 ms | 1.037 ms |
| Turnos medidos | 47 | 8 |
| Llamadas | 18 | 1 |
| Fechas | 26-sep a 13-oct-2026 | 18-oct-2026 |
| Voz | La de producción | La misma |
Fuente: métricas por turno de las conversaciones en ElevenLabs, leídas por Proxera el 18-oct-2026. Sin el saludo inicial.
Si esto es lo tuyo: Lo que hace Xera por tu negocio →
La diferencia es de 32 ms, y hay que leerla con cuidado: del lado de v4 Turbo son solo 8 turnos de una llamada, así que es una primera lectura, no una conclusión. Ese mismo día hicimos otras dos llamadas de prueba en las que cambiamos de voz y de idioma a mitad de conversación, para probar el catalán y las voces nuevas; en ellas la espera fue mayor (medianas de 1.593 ms y 1.912 ms), pero no las comparamos con producción porque cambiaban dos cosas a la vez. Seguiremos midiendo con las llamadas reales y, si la espera empeora de forma que se note, lo contaremos aquí.
Qué cambia para quien llama
- La voz. El asistente habla con Eleven v4 Turbo. Es el mismo guion y la misma forma de atender; cambia el modelo que pone la voz.
- Voces nuevas. Hemos añadido dos voces en castellano, Pablo y Alejandra, y ya son seis. Para el catalán, dos más: Martina y Bernat.
- El catalán. Si lo necesitáis, el asistente también atiende en catalán, sin coste adicional. Flash v2.5 no lo admitía como idioma del agente y v4 Turbo sí. El resto de idiomas de cada plan, en la página del asistente de voz.
Con qué tecnología funciona Proxera
Nos lo preguntan a menudo, y es justo decirlo con nombres. Esto es lo que hace cada proveedor en cada canal, comprobado en nuestra configuración el 18-oct-2026:
| Canal | Proveedor | Qué hace de verdad |
|---|---|---|
| Asistente de voz (teléfono) | ElevenLabs | Reconoce lo que dice quien llama, lleva la conversación y pone la voz (Eleven v4 Turbo). El modelo de lenguaje que decide qué contestar es Qwen3.5, de Alibaba, que elegimos dentro de la plataforma de ElevenLabs: en la voz no usamos ni OpenAI ni Claude. Las llamadas entran por un número de Barcelona de Twilio. |
| Chat de la web y WhatsApp | OpenAI | Redacta las respuestas del asistente de chat, con el modelo GPT-5 mini. El WhatsApp va por la API oficial de WhatsApp Business de Meta. |
| XERA, la plataforma | Claude (Anthropic) | En XERA, cada cliente usa Claude con su propia suscripción, contratada a su nombre. Y nosotros trabajamos con Claude por dentro para preparar, revisar y programar. Claude no atiende a tus clientes en el teléfono ni en el chat. |
| Servidores | Hetzner | Los servidores en los que funcionan la web, el panel, el chat y el servicio del asistente de voz están en centros de datos de Hetzner en Finlandia, dentro de la Unión Europea. |
Lo que hace que el asistente atienda como tu negocio lo construimos nosotros: sus instrucciones, el recado, los avisos, el panel y el filtro de llamadas. Ninguno de estos proveedores es socio ni patrocinador de Proxera: son los servicios que contratamos. La lista completa de proveedores que tratan datos, y sus garantías, está en nuestra política de privacidad.
Qué no cambia para quien ya tiene el asistente
- Tu número de siempre. Sigues desviando las llamadas a tu número Xera de Barcelona, como explicamos en cómo desviar las llamadas con Movistar, Vodafone u Orange.
- El recado. Al colgar te llega el email con el resumen, y en tu panel de voz quedan el audio, la transcripción y el recado.
- Los avisos. El asistente se presenta como IA al empezar y, si lo tienes activado, avisa de que la llamada se graba y se transcribe.
- Los precios. Un cambio de modelo no toca los planes. Si estás comparando, los tienes en cuánto cuesta una recepcionista virtual con IA en España.
Pruébalo
La forma más rápida de saber cómo suena es llamarle: 930 34 78 22. Contesta el asistente de Proxera, y puedes hablarle como lo haría un cliente tuyo, en castellano, catalán, inglés, francés o alemán, o preguntarle si le serviría a tu negocio. Si prefieres hablar con una persona, reserva una llamada y te llamamos nosotros.
IA en acción
¿Quieres ver XERA en acción?
Habla directamente con XERA y descubre cómo puede automatizar las tareas repetitivas de tu negocio.
Sin compromiso
¿Lo prefieres con día y hora cerrados?
Reserva una videollamada de 30 minEliges hueco y te llega la invitación al momento
Contenido Relacionado
Automatizar tu Gestoría en 2026: Guía Práctica para Despachos Profesionales
Guía completa para automatizar tu gestoría o despacho profesional en 2026. Qué automatizar, por dónde empezar y cómo XERA lo hace posible sin cambiar tu software fiscal.
Checklist IRPF 2026 para Gestorías: Calendario, Documentación y Errores que Cuestan Sanciones
Checklist completo IRPF 2026 para gestorías. Todas las tareas pre-campaña, durante y post-campaña. Automatiza con XERA y evita el caos de abril-junio.